不能聊天,也不能写代码,只负责帮你做选择——这种模型听起来像残次品。AI随风这条《超火大模型Jev,保姆级介绍和使用教程》一上来就问:它有什么用?答案很硬:软件里大量判断根本不需要一段话,需要的是一个可执行的决定。
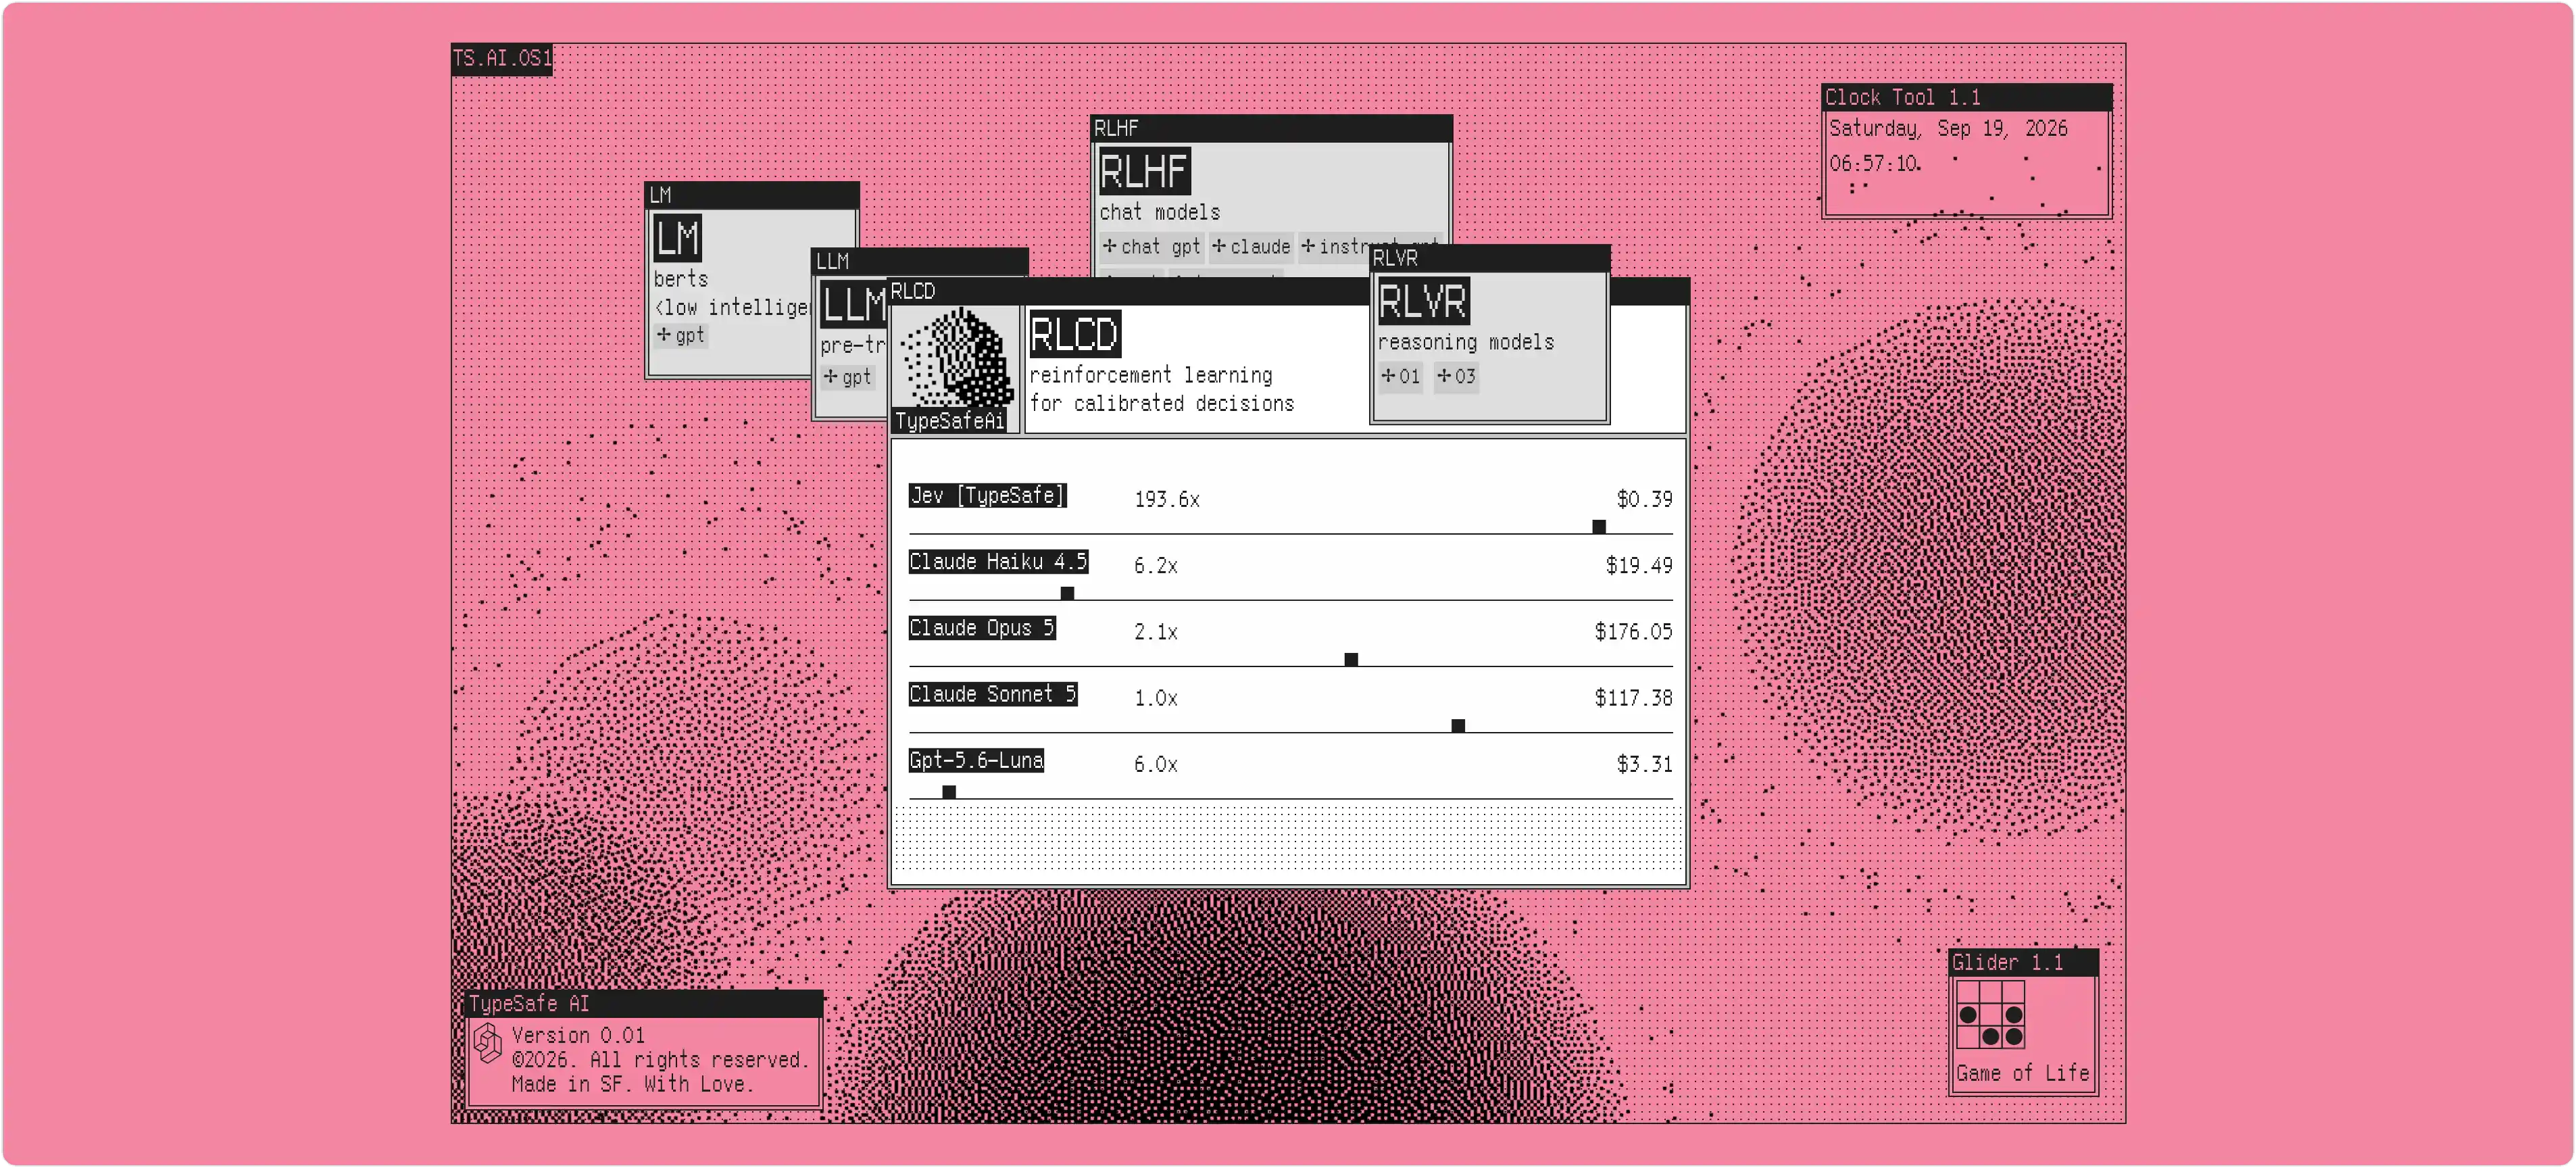
Jev 是 TypeSafe AI 在 2026 年 9 月推出的「System One」模型,名字取自杰文斯悖论:效率提高,需求往往不降反升。它吃进去一段状态(文本或 JSON),吐出来的不是散文,而是带校准概率的结构化判断。官方延迟大致 70–500 毫秒,输入约 $0.042 / 百万 token,输出免费。
评论区两句话特别准:放在大模型前面做路由、放在后面做输出质检都很有用;但它答错或低置信时,工作流必须有人工抽检,不能盲信。
先记住一句话
普通大模型是系统二:慢慢想、一个 token 一个 token 往外写。Jev 被定位成系统一:快、窄、可接入代码。你先规定答案空间,它只在这个空间里打分。所以它「不会写错 JSON 格式」——不是因为它更聪明,是因为它根本不写句子。
把它理解成「前沿智能的函数调用」最顺:状态进,类型化概率出。
三种输出
视频把能力收成三类,和官方原语一一对应。
1. Choice(选项选择)
从你预先列好的选项里选一个,返回每个选项的概率和整体置信度。选项上限官方提到可到 255 个。典型问题:这条工单去账单组、技术组还是销售组?这条请求用便宜模型还是旗舰模型?
2. Noul(是非判断)
自造词,本质是「这句话为真的概率」。返回 0 到 1 的校准概率。典型问题:这封邮件是欺诈吗?用户在要退款吗?这次操作会改生产数据吗?
3. Score(程度评分)
按你定义的有序等级打分,再插值成连续分数。典型问题:情绪有多负面?流失风险多高?这条内容广告味有多重?
三种问题可以打在同一次请求里,对同一段状态并行评估。官方强调:别让它在长上下文里连环推理,把复杂决策拆成一组原子问题,逻辑留给你的代码。
为什么它快、为什么输出能免费
大模型慢,是因为自回归解码:字写得越多,步数越多,还可能格式飘。Jev 走并行采样,一次前向算出所有判断,没有可计费的长文本解码,所以宣传「输出 token 免费」。
训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions):优化的不是「说得讨喜」,也不是「刷可验证答案榜」,而是「我说 70% 把握,同类题里大约就该对 70%」。这把尺子更像考核天气预报员,而不是考核作家。
局限同样清楚:它不解释理由。你拿到的是分布和置信度,不是一篇分析报告。要理由,还得另调生成式模型。
俄罗斯方块实测在证明什么
视频 04:55 用游戏感演示实时决策。官方演示更极端:用 Jev 打 DOOM,大约每秒 10 次选择——前进、左转、开火还是躲。它不看画面散文描述,只看游戏状态,不说一个字,只在选项里挑,并告诉你有多确定。
这不是「Jev 会打游戏」,而是在说延迟敏感场景终于进得去:内容过滤、工具是否该调用、路由要不要升级模型,都可以按百毫秒级插入工作流。单次决策成本低到可以忽略,贵的是后面那次真正的大模型生成。
更多场景:路由、风控、筛选
视频后半和社区落地,基本是同一张菜单:
场景 | 怎么拆问题 | 代码怎么用结果 |
|---|---|---|
模型路由 | Choice 选档位 + Score 估推理强度 + Noul 问是否动真金/真数据 | 高置信走自动执行,低置信升级模型或转人 |
客服分诊 | Choice 选部门,Noul 问是否要退款 | 置信度低于阈值直接人工 |
广告/垃圾识别 | Score 打广告强度,Noul 问是否违规 | 高分拦截,模糊段复审 |
欺诈邮件 | Noul 问是否欺诈,Choice 选风险类型 | 只自动处理高把握样本 |
工具调用筛选 | Noul 问这个工具现在该不该调 | 避免 Agent 乱花工具配额 |
评论打标 | 多路 Choice/Score 并行 | 作者自己做了浏览器插件分析 B 站/YouTube 评论 |
评论里有人问能不能自动交易、能不能选乐透、德州扑克行不行。能套进 Choice/Noul 的「买或卖」在接口形状上成立,但校准概率不是收益保证;乐透更是把随机过程当成可判断问题,模型给不出信息优势。扑克可以当研究玩具,不能当印钞机。
也有人说「这不就是 reranker」。像,但不完全是。Reranker 主要给文档排序;Jev 把选择、打分、是否同时做成软件可消费的原语,并强调概率校准和级联策略。
它必须配合大模型吗?
短答:大多数产品里,是的。
Jev 适合当前置反射弧或后置质检器。难推理、要写作、要写代码、要解释给用户听,仍然是通用大模型的活。一个干净架构是:
- Jev 先判:这件事要不要做、给谁做、用多贵的模型。
- 大模型再生成。
- 必要时再用 Jev 看输出是否跑题、是否像广告、是否该发出去。
置信度分流是关键设计,不是可选装饰:高置信自动走,中置信让大模型复核,低置信人工。评论说「答不了或答错会带崩工作流」,这是对的——抽检和降级路径要写进代码,不要写进愿望。
接入时别被「保姆级」骗了
视频评论吐槽「保姆级使用方法只字不提」,也正常:它不是聊天窗口产品,是 API 原语。实用最小闭环是:
- 准备一段
state(工单原文、邮件、用户请求、游戏状态都可以) - 用 Choice / Score / Noul 写死答案空间
- 读返回的选项、概率、置信度
- 用 if 写策略,而不是再问模型「你再解释一下」
官方和网关侧已有 TypeSafe 直连、OpenRouter、Vercel AI Gateway 等入口,版本常见 jev-latest / jev-1.13.0。上下文有上限(有文档写每请求 64K,state 加问题另有更短限制),问题要短、要互不依赖。
开源侧有人在做浏览器端近似实现(如 open-jev),那是复现「形状」,不等于官方同一套权重。测评数字目前仍大量来自官方自评和发布周实验,独立样本还薄,适合试,不适合把「快 193 倍」写进 KPI 合同。
谁该用,谁不该用
适合: 工单路由、内容审核初筛、Agent 工具门闩、模型成本控制、要毫秒级且输出必须进代码的判断。
不适合: 要聊天、要写方案、要逐步证明、要在开放答案空间里发明新选项、把低置信当高置信去全自动交易。
原视频:https://www.youtube.com/watch?v=GJJq4LXHtW4
视频章节对照
- 00:00 介绍:不聊天的模型解决的是「判断」不是「表达」
- 00:47 三种输出:Choice / Score / Noul
- 04:55 俄罗斯方块/实时决策:证明延迟进得了循环
- 05:34 广告、欺诈、工具筛选:和通用模型分工
- 06:25 总结:快、便宜、结构化,但要级联和抽检
Jev 不是更小的 ChatGPT,是把「if」变成可校准的智能函数。你负责定义问题边界和失败时找谁,它负责在边界里迅速给一个带把握的答案。边界之外,仍然要人,或者仍然要会说话的大模型。
No comments yet